Tableauの運用をAIで自動化しようとして挫折し、Databricks Appsへの乗り換えを進めている話

こんにちは!株式会社データ・ワンでエンジニアをやっている曽根高です。

社内で利用しているダッシュボード基盤のTableauからDatabricks Apps(AppKit)への移行を進めています。
きっかけは「Tableau の手作業を AI で減らせないか」という試みです。
弊社では、開発の大部分でClaude CodeやCodexといったAIを活用した効率化が進んでいますが、Tableauは手作業が残っており、開発のボトルネックになっていました。
結果的に、AIによるTableau作業の効率化は2回失敗して挫折しましたが、Tableauで抱えていたいくつもの課題をDatabricks Appsに乗り換えることで解決できることがわかりました。

ここからは、AIによるTableau作業の自動化を目指して試したことや、Databricks Appsへ移行することで得られたメリット・移行方法について具体的にお話ししていきます。

続きを読む

店頭サイネージの広告効果を因果推論手法から想像してみる

0. はじめに

はじめまして。株式会社データ・ワンでプロダクト開発部の吉田です。

広告の世界には、問われ続けている問題として「その広告を見た人は、本当にその商品を買ったのか」というのがあります。様々な広告や販促で効果は語られてきました。
これに対して私たちはオフラインの購買データと広告配信実績の掛け算で答えています。
この記事では、私たちがどんなデータを持っていて、どのような分析例でもって答えようとしているのか一例を示すことでデータの面白みに気づいてもらえたらと思いまして書いております。※以下の例は必ずしも提供しているものというわけではなく分析の一例としてご理解いただければと思います。

 1. 会社とデータ紹介

データ・ワンは、小売の購買データをファミリーマートを中心にドラッグストアやディスカウントストアをID-POSを軸にデータ連携をして保有しています。

一般的には広告会社は「広告を届けること」を仕事にします。私たちの仕事は少し違っていて、購買という結果の側から逆算して、広告の設計を振り返る点にあります。誰が何をいつ買ったかが分かるなら、「誰に何を見せるべきだったか」も原理的には分かるはずだ、という発想です。

プロダクト開発部は、そのためのデータ基盤(Databricks / Delta Lake等)、分析エンジン、そしてプランニングツールといったアプリケーションまでを一気通貫で持っています。SQLとSparkを書く人、統計モデルを組む人、Next.jsでUIを作る人が、同じ問いの周りに座っている構成です。


2. データ・ワンが持っているデータ

私たちが扱うデータは、大きく3つの層に分かれます。
1) 購買データ。コンビニエンスストアを中心とした、会員IDに紐づくPOS情報です。
2) メディア接触データ。デジタル広告配信ログ、店頭サイネージの配信ログ、そしてテレビの視聴データ。それぞれ「誰に、いつ、どの広告が出たか」の記録です。
1)と2)の組み合わせが我々の特徴をつくっており、広告効果測定が難しいのは、たいていの場合「接触した人の集合」と「買った人の集合」が別々のデータソースにいて、両者を人単位で突き合わせられないからです。突き合わせられないから、期間比較や地域比較といった間接的な方法に頼ることになり、そこに交絡が入り込む。私たちはこの前提条件を構造的に外せる位置にいます。


3. ファミマTVのマーケティング観点での価値

ファミマTV(FTV)は、ファミリーマートの店内に設置されたデジタルサイネージのネットワークです。レジ前や店内で映像が流れる、あの面のことです。

このメディアは、広告の分類でいうと少し変わった位置にいます。

テレビCMのようなマス広告は、広く届く代わりに「誰に届いたか」が推定になります。デジタル広告は誰に届いたかが分かる代わりに、購買という行為からは物理的にも時間的にも遠い。ファミマTVは、マス的な到達(店内に幅広く届く)とデジタル的なログ(どの枠が、いつ、どの店で流れたか)の両方を持っています。

ただ、本当に特殊なのはそこではありません。

このメディアは、購買の意思決定が起きる場所そのものに置かれているということです。広告を見てから商品に手を伸ばすまでの距離が、数十メートル。時間にして数分。

広告効果測定という観点では、これは非常に恵まれた条件です。接触から購買までの間隔が長いほど、その間に他の要因(別の広告、口コミ、セール、季節)が入り込み、「その広告のおかげで買ったのか」が分からなくなる。ファミマTVでは、この交絡要因が入り込む隙間が構造的に小さい。

分析をする人間から見ると、これは"実験に近い状況が自然に発生している場所"なんです。


4. 分析例: 因果推論で、これから何が見えてきそうか

ここから先が、この記事でいちばん書きたかったところです。

先に断っておくと、この章に分析結果の数字は出てきません。効果がどれくらいあったか、どのカテゴリで効いたか、といった話は書きません。ひとつには、それがクライアントの資産だからです。そしてもうひとつ、より本質的な理由として、**この仕事のいちばん面白い部分は、結果ではなく問いの立て方にある**と考えているからです。

私たちがいま向き合っているのは、大きく3つの問いです。


問い1:見た人は、本当に買ったのか

標準的なレポートとしては配信した期間の対象商品の売上推移。配信店と非配信店の比較。接触者と非接触者の購買率を想定しますが、

さらに「では、次はどこに出せばいいか」「予算を1.5倍にしたら、効果も1.5倍になるのか」「この商品で効いたなら、隣のカテゴリでも効くか」という問いを想定します

これに答えるために因果推論という手法で考えてみます。この手法はいいかえると「あり得たもう一方の世界」を反事実(counterfactual)を仮定して考察する手法になります。

その理論に踏み込みませんが、見える分析例としては以下のような形になります。
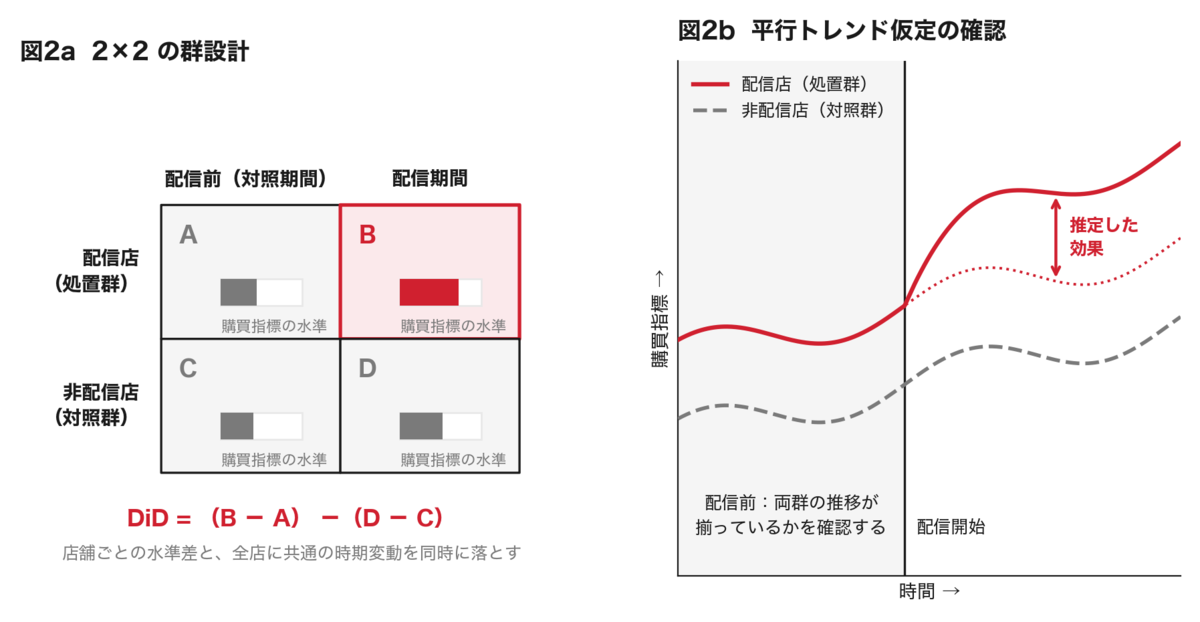
この例では、店舗の軸と期間の軸を掛け合わせて群を4つに切ります。

配信店の配信前(A)と配信期間(B)の差から、その店舗で起きた変化を取る。同じことを非配信店(C→D)でも取る。そして、その2つの差をもう一度引く。差分の差分(Difference-in-Differences, DiD)です。

ここで非配信店が担っているのが、まさに反事実の役です。「配信していなかったら、この期間の売上はこう動いていたはず」を、実在する店舗の実データで代理させている。季節性や景気や同時期の他の販促は、非配信店にも同じように効いているので、二度目の引き算で相殺されます。

この設計にはひとつ前提が付きます。配信がなかったとしたら、両群は同じように推移していたはずだという仮定です。そしてこの前提は、検証できます。配信が始まる前の期間で、両群の推移が実際に平行になっているかを見ればよい(図2b の左半分)。

ここが、レポートと因果推論の分かれ目です。レポートは「起きたこと」を示します。因果推論は「起きなかった方を、こう置いた」という前提そのものを図として差し出す。だから推定した効果に、どこまで一般化してよいかという範囲が付いてきます。予算を振り替える判断に使えるのは、こちらの形です。

さらに、ID連携が効く条件が揃えば、店舗ではなく人の単位でも同じことができます。接触したIDの集合に対する反事実を、購買履歴の似た非接触IDの集合で作る(傾向スコアマッチング)。こうすると「この商品をよく買う層に、広告は何を上乗せしたのか」という形で答えが出ます。


問い2:その効果は、どこまで広がっていたのか

問い1が解けると、その隣にもうひとつ問いが立ちます。効果の範囲です。

店内で広告を見た人が、その店で買うとは限りません。その日は買わずに翌日、別の店で買うかもしれない。同じチェーンの別店舗かもしれないし、まったく違うチェーンかもしれない。

これを追いかけると、同じ案件から2種類の新しい情報が出てきます。

ひとつは、効果の届いた範囲。設置店で観測された購買の外側に、どれだけ購買が生まれていたか。ここが測れると、案件の評価に「設置店での売上」以外の項目が加わります。

もうひとつは、伸びの構成。設置店の売上が伸びたとき、それが新しく生まれた購買なのか、近隣店から移動してきた購買なのか。前者なら送客、後者ならカニバリゼーションで、チェーン全体に対する意味が変わります。

この2つ、集計した売上の増減だけを見ていると同じ観測になります。区別する軸が入っていないからです。
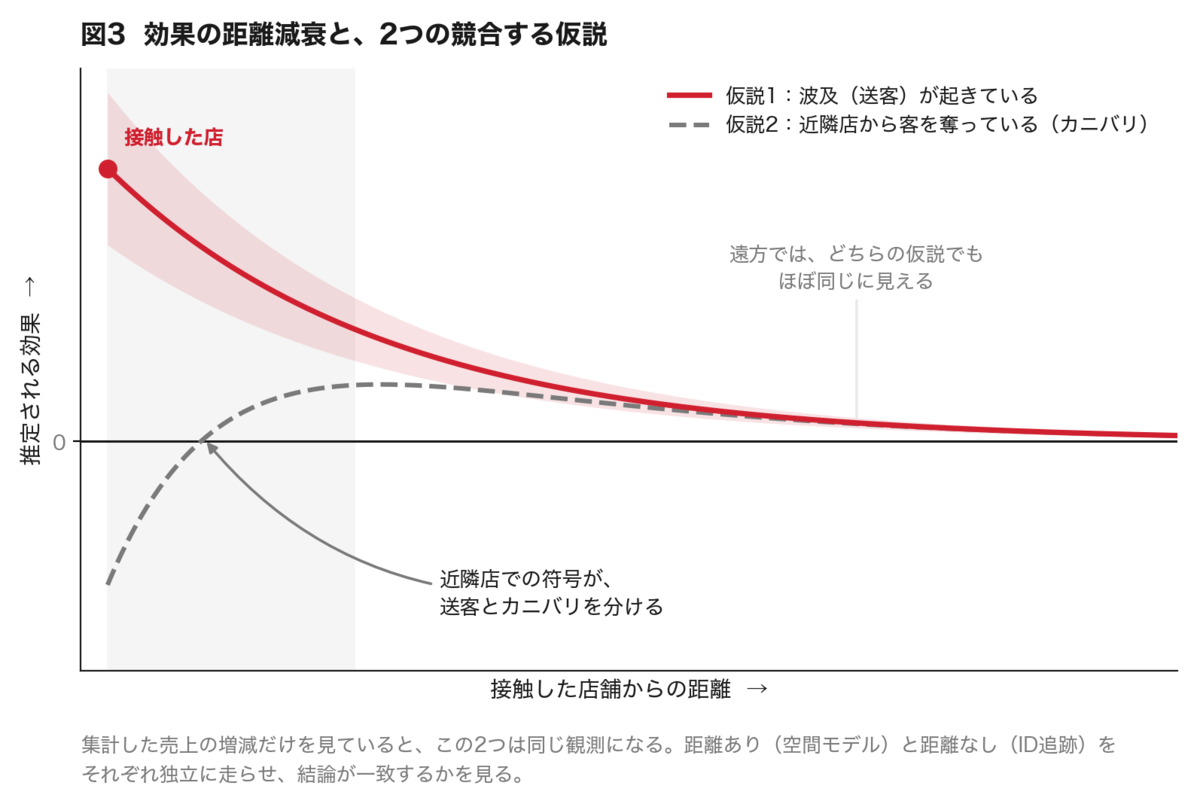
効果の距離減衰と、2つの競合する仮説

そこで距離という軸を一本入れると、両者が分かれます。波及なら、接触店から離れるにつれて効果は正の側から緩やかに減衰していく。移動なら、近隣店では効果が負に振れ、遠方に行くにつれてゼロに戻る。近距離での符号が、2つの解釈を識別するわけです。

ひとつは距離を使う経路。接触店からの距離に応じて効果がどう減衰するかを、空間的なモデルで推定します。もうひとつは距離を使わない経路。ID連携で「接触した人が、その後どこで買ったか」を直接追いかけます。

前者は店舗の位置関係から、後者は人の行動から、同じ現象に別々の側から近づいています。両者の結論が一致すれば、確信度が上がるということになります。


問い3:その他広告と重ねたとき、配分をどう変えるべきか

3つめは、予算配分に直結する問いです。

同じブランドがその他広告とファミマTVを同時期に出稿するケースは珍しくありません。このとき、両方に接触した人の購買率がいちばん高いという結果はよく出ます。重ねることに意味がある、という手応えは既にあります。

ここに反事実の考え方を持ち込むと、配分の話にできます。

その他広告だけで既に届いていた人に、店頭でもう一度当てたことの効果はいくらか。逆に、テレビが届いていなかった人に店頭が初めて届いたことの効果はいくらか。この2つが分かれると、次の出稿で「その他広告を減らして店頭に寄せるべきか」が推定量の比較になります。

その他広告IMPデータとの突合ができれば接近できます。接触パターンで4群に分ける——両方に接触、その他広告のみ、ファミマTVのみ、どちらにも未接触。そのうえで、それぞれに対する反事実を置いて比べるということが可能になります


締め

ここまで、3つの問いの立て方を書きました。
あくまで分析の1例をご紹介しましたが、我々は豊富なデータで様々な分析手法をさがし、日々開発しています。


5. 採用情報

データ・ワンではエンジニア・プロダクトマネージャーを募集しております。募集の内容は以下のリンクをご確認ください。
https://data-one.co.jp/recruit/recruit_dev.html
共役事前分布は「都合がいいだけ」なのか?ベータ分布とベルヌーイ分布で確かめてみた

初めまして。株式会社データ・ワンの望月です。

普段は分析の相談対応やレポート作成をしているのですが、大学で数学を専攻していたこともあり、最近はデータサイエンスの勉強をしており、現在はPRML(Pattern Recognition and Machine Learning)を読み進めています。

PRMLを読んでいると、「ベルヌーイ分布の共役事前分布(conjugate prior)はベータ分布」「多項分布の共役事前分布はディリクレ分布」といった対応表のような説明がたびたび出てきました。

最初は「そういうものらしい」となんとなく受け入れて読み進めていたのですが、いざ「数学的にはどういう意味なのか」「何が嬉しいのか」を自分の言葉で説明しようとすると、意外と言葉に詰まってしまいました。

この記事では、一番シンプルな組み合わせであるベルヌーイ分布とベータ分布を使って、この「当たり前に見える対応関係」を実際に手を動かして確かめてみます。

共役事前分布とは何か

まず言葉の定義を確認します。

事前分布  p(\theta) と尤度  p(D\mid\theta) があるとき、ベイズの定理から事後分布は次の形で計算できます。

 p(\theta \mid D) \propto p(D\mid\theta)\,p(\theta)

この事後分布  p(\theta\mid D) が、事前分布  p(\theta) と同じ「分布の種類(族)」になるとき、その事前分布は尤度に対して共役であるといいます。

言葉だけだと分かりにくいので、次の章で実際に計算してみます。

具体例:ベルヌーイ分布とベータ分布

コインを1回投げて表が出るかどうかを  x \in \{0,1\}(表なら1、裏なら0)とし、表が出る確率を  \theta とすると、1回の試行の確率分布は次のように書けます。

 p(x\mid\theta) = \theta^{x}(1-\theta)^{1-x}

これがベルヌーイ分布です。 x=1(表)のとき  p(x\mid\theta)=\theta x=0(裏)のとき  p(x\mid\theta)=1-\theta になっているだけの、素直な確率分布です。

このコインを独立に  n 回投げたデータ  D=\{x_1,\dots,x_n\} を考えます。各試行は独立なので、尤度はベルヌーイ分布の積になります。

  1.  n 回分のベルヌーイ分布を掛け合わせる
     p(D\mid\theta) = \prod_{i=1}^{n} \theta^{x_i}(1-\theta)^{1-x_i}
  2. 表が出た回数を  m=\sum_{i=1}^{n} x_i とおくと、指数部分をまとめられる(表の回数の合計が  m、裏の回数の合計が  n-m になります)
     p(D\mid\theta) = \theta^{m}(1-\theta)^{n-m}

 n 回分のベルヌーイ分布の積が、表の出た回数  m だけで決まる形にまとまりました。ここまでが尤度の部分です。

 \theta についての事前の知識を、ベータ分布で表します。

 p(\theta) = \mathrm{Beta}(\theta\mid a, b) = \frac{\theta^{a-1}(1-\theta)^{b-1}}{B(a,b)}

 a, b は事前分布の形を決めるパラメータ、 B(a,b) は正規化のための定数です。

事後分布を導出する

ベイズの定理に従って、尤度と事前分布を掛け合わせます。

  1. まず両者を掛け合わせる(正規化定数は比例関係なので今は無視します)
     p(\theta\mid D) \propto \theta^{m}(1-\theta)^{n-m}\cdot\theta^{a-1}(1-\theta)^{b-1}
  2. 同じ底  \theta どうし、 1-\theta どうしの指数をまとめる( \theta^{x}\cdot\theta^{y}=\theta^{x+y} という、ただの指数法則です)
     p(\theta\mid D) \propto \theta^{\,m+a-1}(1-\theta)^{\,n-m+b-1}
  3. 得られた式の形を確認する

これは  \mathrm{Beta}(a+m,\ b+n-m) の関数形そのものです。事前分布はベータ分布だったのに対し、事後分布もベータ分布になりました。パラメータが  (a,b) から  (a+m,\ b+n-m) に更新されただけで、分布の種類自体は変わっていません。

これが「共役性」の中身です。難しい話に見えて、実際は指数法則で指数が足し算になっただけ、というのが最初の発見です。

当たり前をもう一歩掘る:ハイパーパラメータは本当に「疑似データ」なのか

PRMLなどでは、ベータ分布のパラメータ  a, b について「事前に  a-1 回の成功、 b-1 回の失敗を観測したのと同じ」という説明がよく出てきます。これは比喩として広く使われていますが、本当にそう言えるのかを実際に計算して確認してみます。

事後分布  \mathrm{Beta}(a+m,\ b+n-m) の平均を計算します。ベータ分布の平均は  \alpha/(\alpha+\beta) という公式があるので、そのまま当てはめます。

  1. 事後分布の平均をそのまま公式に当てはめて計算する
     E[\theta\mid D] = \frac{a+m}{a+b+n}
  2. この式を「事前分布の平均」と「データだけから計算した割合」の重み付き平均の形に分解する(分数を2つの項に分けただけです)
     E[\theta\mid D] = \frac{a+b}{a+b+n}\cdot\frac{a}{a+b} \;+\; \frac{n}{a+b+n}\cdot\frac{m}{n}
  3. それぞれの項の意味を確認する
  •  \dfrac{a}{a+b} は事前分布  \mathrm{Beta}(a,b) の平均そのもの
  •  \dfrac{m}{n} はデータだけから計算した「表が出た割合」(最尤推定値)そのもの
  • 2つの重み  \dfrac{a+b}{a+b+n} \dfrac{n}{a+b+n} は足すと1になる

つまり事後分布の平均は、「事前分布が持っていた意見」と「データが示す意見」を、 a+b n の比で混ぜ合わせたものになっています。

ここまで計算してみると、「 a, b は疑似的に  a+b 回分のデータを事前に見ていたようなもの」という説明は、単なる比喩ではなく、実際の計算から出てくる事実だったと分かります。

なぜ共役性は大事なのか

ここまでで「事後分布が事前分布と同じ形になる」ことと、「それが疑似データとして解釈できる」ことを確認しました。ただ、これだけだと「数学的にきれいな性質」という話で終わってしまいます。実務的にありがたいのはどこなのか、2つに分けて確認します。

1. 正規化定数を計算しなくていい

ベイズの定理は、正確には次のような形をしています。

 p(\theta\mid D) = \frac{p(D\mid\theta)\,p(\theta)}{p(D)}

分母の  p(D) は正規化定数(エビデンスとも呼ばれます)で、次の積分で定義されます。

 p(D) = \int_0^1 p(D\mid\theta)\,p(\theta)\,d\theta

この記事の最初のほうでは「比例関係なので無視します」と済ませましたが、実際にはこの積分を計算しないと事後分布の値そのものは求まりません。一般の事前分布では、この積分は解析的に解けず、数値積分やサンプリング(MCMCなど)に頼ることになります。

ここで、共役事前分布を使った場合にこの積分がどうなるか、実際に計算してみます。

  1. 尤度と事前分布を代入する
     p(D) = \int_0^1 \theta^{m}(1-\theta)^{n-m}\cdot\frac{\theta^{a-1}(1-\theta)^{b-1}}{B(a,b)}\,d\theta
  2. 指数をまとめて、定数  B(a,b) を積分の外に出す
     p(D) = \frac{1}{B(a,b)}\int_0^1 \theta^{\,a+m-1}(1-\theta)^{\,b+n-m-1}\,d\theta
  3. 残った積分の形を確認する

この積分は、まさにベータ関数  B(a+m,\ b+n-m) の定義そのものです。したがって

 p(D) = \frac{B(a+m,\ b+n-m)}{B(a,b)}

となり、数値的に近似する必要がなく、既知の関数(ベータ関数)の値としてそのまま求まります。ベータ関数は  B(\alpha,\beta)=\Gamma(\alpha)\Gamma(\beta)/\Gamma(\alpha+\beta) とガンマ関数(正の整数のときは階乗)で書けるので、積分記号が完全に消えるわけではなくても、最終的には四則演算だけで値が出る「解かれている積分」になっています。

もし事前分布がベータ分布以外の、何か適当な形の分布だったら、この積分は一般には閉じた式にならず、数値積分や近似計算が必要になります。共役事前分布を選ぶということは、「この積分が最初から解けている状態を用意しておく」ということだと言えます。

2. データを後から追加しても、最初からやり直さなくていい

もう一つの利点は、データが後から追加で届いたときの更新のしやすさです。

最初のデータ  D_1 n_1 回中  m_1 回成功)で事後分布を求めると

 p(\theta\mid D_1) = \mathrm{Beta}(a+m_1,\ b+n_1-m_1)

になります。ここで、あとから新しいデータ  D_2 n_2 回中  m_2 回成功)が届いたとします。このとき、 p(\theta\mid D_1) を「新しい事前分布」として扱い、同じ手順でもう一度更新します。

 p(\theta\mid D_1, D_2) = \mathrm{Beta}\big((a+m_1)+m_2,\ (b+n_1-m_1)+n_2-m_2\big)
 = \mathrm{Beta}(a+m_1+m_2,\ b+n_1+n_2-m_1-m_2)

これは、最初から  D_1 D_2 を合わせた  n_1+n_2 回のデータで一気に計算した場合とまったく同じ結果です。つまり、過去のデータそのものを保存しておく必要はなく、「今の事後分布のハイパーパラメータ(累積の成功・失敗数)」だけを持っておけば、新しいデータが来るたびにその場で更新できます。

この2点、「正規化定数が解析的に求まる」ことと「過去のデータを持たずに逐次更新できる」ことが、共役事前分布が便利だとされる実務的な理由です。

おまけ:データが増えるとどうなるか

上の重み付き平均の式で、データの数  n が大きくなっていく場合を考えます。 a, b を固定したまま  n だけを大きくすると、重み  \dfrac{n}{a+b+n} は1に近づき、逆に  \dfrac{a+b}{a+b+n} は0に近づいていきます。

つまりデータが十分に増えれば、最初にどんな事前分布を置いていたとしても、事後分布の平均はデータだけから計算した割合  m/n に近づいていきます。事前分布の「意見の強さ」を表していた  a+b は、データの量  n に比べて相対的に軽くなっていく、というだけの話です。

まとめ

  • 共役事前分布とは、事後分布が事前分布と同じ分布の種類になるという性質のこと
  • ベルヌーイ分布とベータ分布の場合、掛け算した結果の指数が足し算になるだけで、事後分布もベータ分布になる
  • ベータ分布のパラメータ  a, b が「疑似的なデータ」として機能しているというのは比喩ではなく、事後平均を重み付き平均の形に分解すると実際にそう解釈できることが確認できる
  • 共役事前分布を使うと、本来なら数値的にしか求まらない正規化定数が解析的に求まり、さらに過去のデータを持たずに逐次更新ができる。これが実務的な「大事な理由」にあたる
  • データが増えるほど、事前分布の影響は薄れていく

「共役性がある」というのは、計算がラクになるという実用上の便利さの話であると同時に、事前分布とデータの「意見」がどういう比率で混ざり合うかを、綺麗な式で説明できるという面白さもある、という話でした。

AIエージェントをスクラム開発に組み込んでベロシティは上がったのか

こんにちは。株式会社データ・ワンでデータエンジニアをしている小宮です。

2026年2月にジョインして早いもので約半年が経ちました。現在はデータ基盤の運用、プロダクト側のアプリケーション開発もやりながらスクラムマスターをしています。


この記事では、Claudeを利用したAIエージェントをこの数ヶ月でスクラム開発に組み込み、試行錯誤してきた事例を紹介します。

果たしてベロシティ(チームの生産性)は上がったのでしょうか...

本番アラートの一次対応をエージェントに任せる

アラート対応。好きですか?私は好きです(大嘘)

スクラムのスプリント計画を崩す最大の要因、それは割り込みタスクです。

中でも本番アラートによる割り込みはいつどのタイミングで発生するかわからないので、多く発生すると計画通りに進まなくなってしまいます。

弊社にはデータ基盤で動いているバッチや、自社DSP(広告配信のシステム)があり、Slackにアラートが届くたびに、進行中のタスクを中断して対応する必要がありました。


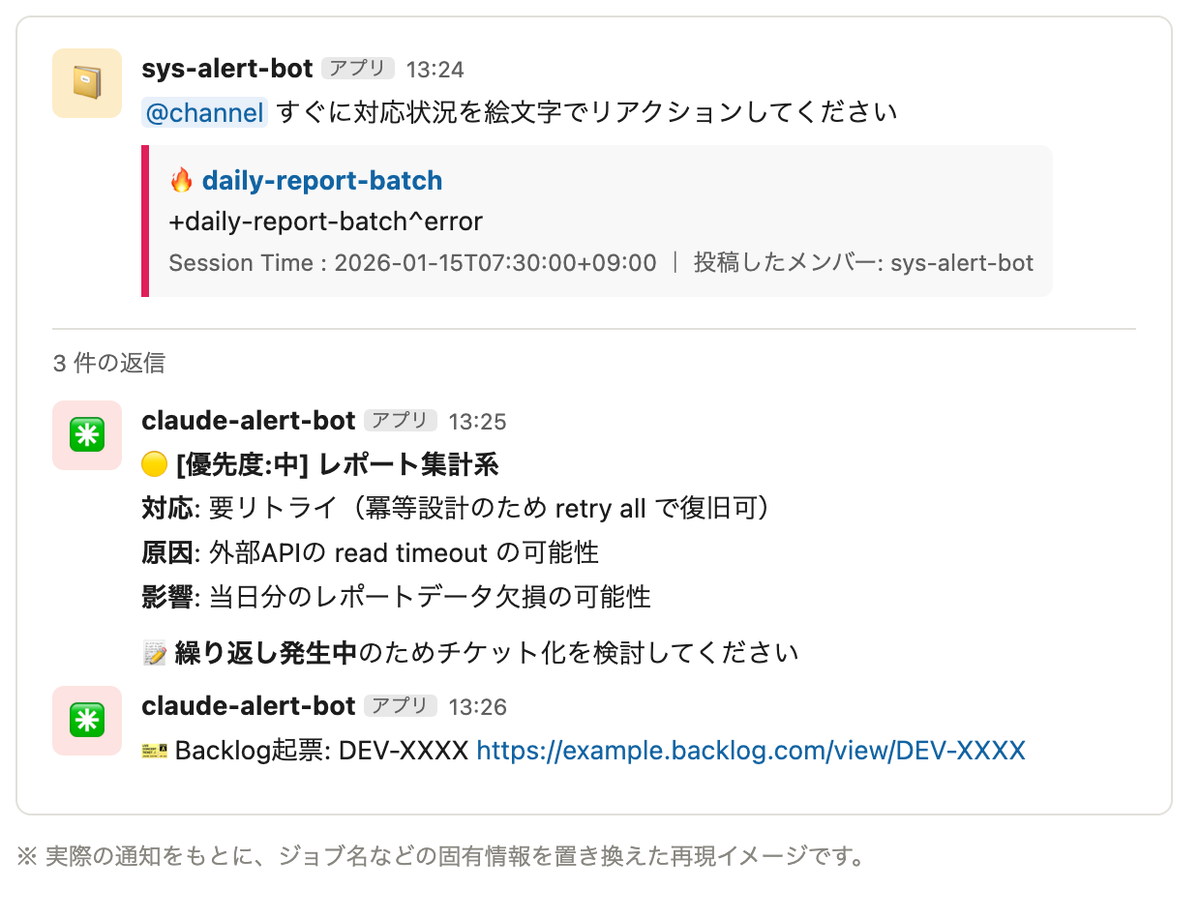
そこで、アラートの一次対応を行う常駐の監視エージェントを入れました。

アラートを検知すると、過去事例との突合とログの抽出、原因候補の提示までを自動で行い、結果をSlackのスレッドに返します。

再発している既知のパターンについては、修正PRの作成とステージングデプロイ・検証までエージェントが自動で進めてくれるので、人は最後のレビューだけを行います。


設計〜実装をエージェントに任せる

Claudeを導入してから徐々にエージェントに開発作業を任せるようになり、今ではチケットキーを渡すとエージェントが情報収集、コードベース調査、設計案の提示、実装までを進めてくれるようになりました。

エージェントを使い出した初期は開発フローが定まっておらず、出来上がったものが全然想定通りにならず手戻りも多く発生していました。


開発フローの改善を重ねて、現在はsuperpowersのbrainstormingやwriting-plansなどで人間が設計対話を行い、合意後の実装やPR作成等はエージェントに任せるフローに落ち着いています。

PR作成後のCIでClaude, Codexの自動レビューが動き、レビューコメントとCIがGreenになるまでローカルのClaudeがモニターしてくれます。All Greenになるまで監視と修正を実施してくれるので、その間別の作業を行うことができています。


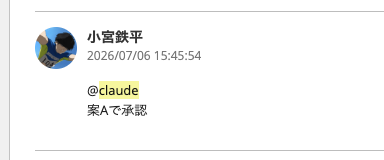
先ほど紹介したアラート対応の監視エージェントが起票したチケットには、設計や対応案がすでに記載されているため、Backlogに承認コメントすることで自動的に実装を進めるようにしています。

Backlogのコメントをポーリングしている常駐エージェントもいる


レビューをエージェントに任せる

弊社の開発チームの中には営業からの分析に対応するアナリストチームがあります。

レビューは開発・アナリストどちらからも飛んでくるので、AIで実装スピードが上がった分、人間レビューによるボトルネックが発生します。

実際に私がレビューを捌ききれずレビュー待ちチケットが溜まってしまう問題がありました。

そこで現在はレビューのほとんどをエージェントに任せています。

AIが活用できるように社内のドメイン知識をGitHubの特定のリポジトリに溜めており、そこを参照しながらレビューを行ってくれます。これもチケットキーを入れれば情報収集からレビューまでエンドツーエンドで実施してくれます。


これによりレビューが以前より高速化しました。ただ、最終的に人間が判断しなければならない部分も多いため、いろいろ高速化した分理解する時間を多めに取るようにしています。大量の文章を読むのは疲れるのでClaudeのアーティファクト機能をよく利用しています。


で、ベロシティは上がったのか

上がりました。徐々に。

割り込みで手が止まる回数が減り、タスクやレビューに着手するコストも下がり、並列で複数のタスクを進めることができています(タスクの種類による)。


何より、チーム全員がAIに対する熱量がすごいのでスプリントを重ねながらどんどんブラッシュアップしています。運用が軌道に乗ってきた直近のスプリントでは、ベロシティが最大で2倍になったこともありました。

現在では開発フローのほぼ全てをエージェントが担っています。人間に残された仕事は何をやるかを決めることになってきています。


今回紹介した内容はAI活用のほんの一部です。Claudeはどんどん新しい機能が出ていて、チームでもAIの感度が高い人ばかりで刺激的です。AI関連の記事を今後も執筆する予定なのでお楽しみに!


採用情報

データ・ワンではエンジニア・プロダクトマネージャーを募集しております。募集の内容は以下のリンクをご確認ください。

data-one.co.jp